Comparez ce que les utilisateurs croient, ce que le système réussit et la manière dont ils s’appuient sur lui. L’objectif n’est pas de maximiser la confiance, mais de permettre un recours approprié.
Responsable produit IA et recherche utilisateur
La décision à éclairer : Ajouter des erreurs plausibles au protocole utilisateur, avec une référence validée.
Une bonne note de satisfaction peut cacher une erreur non détectée
Un lecteur trouve une réponse claire et rassurante parce qu’il ne possède pas les connaissances nécessaires pour la vérifier. Il peut noter le service favorablement tout en repartant avec une information incorrecte. La satisfaction ne constitue donc pas une validation de fond.
Évaluez des cas dont la réponse correcte est connue. Demandez ensuite confiance, décision et vérification effectuée. Cette combinaison révèle si les personnes repèrent les réponses fragiles ou acceptent tout avec la même assurance.
La confiance et le comportement ne se confondent pas
Lee et See expliquent que la confiance influence le recours à l’automatisation sans le déterminer seule. Buçinca, Malaya et Gajos étudient des mécanismes de contrôle cognitif avec 199 participants. Ces travaux invitent à regarder la décision effective, pas seulement une opinion sur l’outil. (John D. Lee et al., 2004)(Zana Buçinca et al., 2021)
Une interface qui ralentit la décision peut réduire certaines erreurs mais aussi ajouter une charge. Le bon contrôle doit donc être proportionné à la tâche et à ses conséquences.
Une préférence pour l’algorithme ne mesure pas sa justesse
Logg, Minson et Moore observent, dans six expériences, une préférence pour certains conseils présentés comme algorithmiques. Cette appréciation varie selon les conditions. Elle complète les travaux sur la confiance : une bonne évaluation subjective peut exister sans test suffisant de la fiabilité réelle du système que vous déployez. (Jennifer M. Logg et al., 2019)
Présentez séparément la réussite sur des cas vérifiés, le sentiment de confiance et les décisions réellement prises. Examinez particulièrement les situations où l’utilisateur suit une réponse fausse avec assurance. Si la confiance augmente après une amélioration visuelle mais que les erreurs restent identiques, le produit n’est pas nécessairement devenu meilleur. Il faut rendre les limites de la réponse plus faciles à reconnaître au moment du choix.
Construire une matrice de confiance et de justesse
Classez les réponses correctes et incorrectes, puis regardez si elles ont été acceptées ou contestées. Les erreurs acceptées avec assurance méritent une attention particulière. Les bonnes réponses systématiquement rejetées signalent un autre défaut de compréhension ou d’utilité.
Le métier prépare les références ; la recherche observe les usages ; le produit corrige les indices trompeurs. Évitez les pourcentages de confiance produits librement par le modèle sans calibration sur des données adaptées.
Croiser la justesse et la décision de suivre
Présentez les résultats sous forme de cas croisés : bonne réponse acceptée, bonne réponse rejetée, erreur repérée et erreur acceptée. Cette grille évite de traiter toute confiance comme un succès. Ajoutez les raisons données par les participants : citation, ton, expérience antérieure ou impossibilité de vérifier. Le produit peut alors corriger un indice précis. Si les lecteurs acceptent une réponse parce qu’une source est affichée, testez si cette source soutient réellement l’affirmation et si le passage pertinent est accessible au moment de décider.
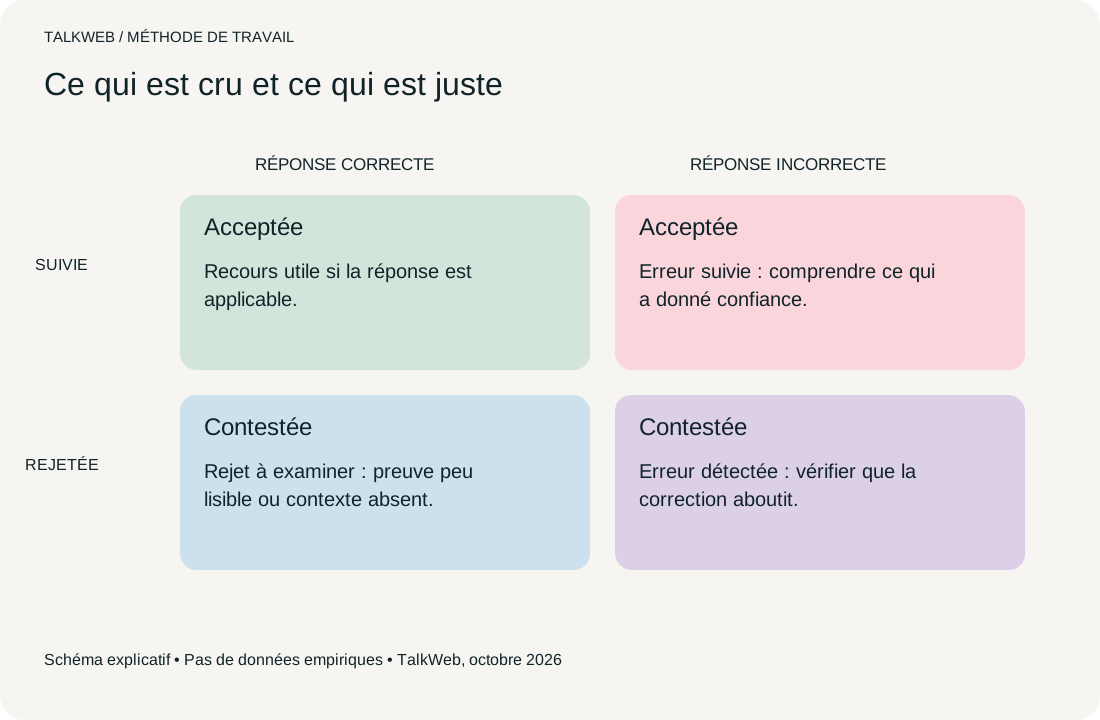
Schéma de méthode proposé par TalkWeb, à adapter au contexte. Aucun résultat mesuré n’est représenté.
Télécharger le schéma SVG ↓Une équipe teste un assistant de procédures avec des réponses correctes et des erreurs plausibles
Une équipe teste un assistant de procédures avec des réponses correctes et des erreurs plausibles. Dans ce scénario fictif, certaines réponses erronées sont très bien notées. Le problème n’est pas corrigé en ajoutant un badge rassurant : l’équipe rapproche source, règle applicable et décision attendue pour rendre la vérification possible.
Corriger les indices qui donnent une autorité injustifiée
Un ton catégorique, une citation non pertinente ou une mise en page très officielle peuvent renforcer une réponse faible. Rendez le périmètre et la preuve accessibles au moment où ils sont utiles.
Suivez les erreurs effectivement détectées et les décisions corrigées. Une baisse de confiance déclarée peut être un progrès si elle correspond à une meilleure reconnaissance des limites réelles.
Vérifiez aussi quelles erreurs un expert métier détecte réellement, plutôt que de supposer que son expérience garantit le contrôle.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| Perception | Mesurer la confiance déclarée | Recherche UX |
| Justesse | Comparer à une référence | Métier |
| Usage | Observer acceptation et correction | Produit |
La décision à retenir
Comparez ce que les utilisateurs croient, ce que le système réussit et la manière dont ils s’appuient sur lui. L’objectif n’est pas de maximiser la confiance, mais de permettre un recours approprié.
- Votre prochaine étape
- Ajouter des erreurs plausibles au protocole utilisateur, avec une référence validée.
- Comment juger le résultat
- Les personnes discriminent mieux réponses solides et réponses fragiles.
Les limites de cette analyse
- Cadre conceptuel historique ; pas de score de fiabilité pour un modèle actuel.
- Tâches expérimentales ; les contraintes ajoutées peuvent réduire l’acceptabilité.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
John D. Lee, & Katrina A. See. (2004). Trust in Automation: Designing for Appropriate Reliance. RECHERCHE · Human Factors.
DOI : 10.1518/hfes.46.1.50.30392 ↗Conclusion et cadre conceptuel du PDF auteur consultés ; revue théorique, pas essai de chatbot.
Voir la fiche de preuve
- Constat
- La confiance influence le recours à l’automatisation sans se confondre avec lui ni le déterminer seule.
- Localisateur
- Conclusion et cadre conceptuel du PDF auteur consultés ; revue théorique, pas essai de chatbot.
- Court extrait
- « Trust influences reliance on automation »
- Méthode
- RECHERCHE · Human Factors
- Population
- Population et périmètre précisés dans la lecture citée ; pas de mesure conduite par TalkWeb.
- Limites
- Cadre conceptuel historique ; pas de score de fiabilité pour un modèle actuel.
Zana Buçinca, Maja Barbara Malaya, & Krzysztof Z. Gajos. (2021). To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making. RECHERCHE · CSCW.
Publication originale ↗PDF ouvert ; résumé, dispositif et discussion des fonctions de forçage cognitif.
Voir la fiche de preuve
- Constat
- L’expérience avec 199 participants observe une réduction de la dépendance excessive dans certaines conditions de forçage cognitif.
- Localisateur
- PDF ouvert ; résumé, dispositif et discussion des fonctions de forçage cognitif.
- Court extrait
- « To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making »
- Méthode
- Expérience comparant plusieurs modalités d’assistance et fonctions de forçage cognitif.
- Population
- 199 participants aux tâches expérimentales.
- Limites
- Tâches expérimentales ; les contraintes ajoutées peuvent réduire l’acceptabilité.
Jennifer M. Logg, Julia A. Minson, & Don A. Moore. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes.
DOI : 10.1016/j.obhdp.2018.12.005 ↗Résumé primaire consulté ; texte intégral non audité.