Exposez les éléments vérifiables du processus : données d’entrée, règle applicable, calcul ou source. Un texte généré qui semble logique ne prouve pas que le système a suivi ce raisonnement.
Product owner d’un outil d’aide à la décision et analyste métier
La décision à éclairer : Comparer les explications générées à la trace de calcul sur des cas de recette.
« Pourquoi ce montant ? » appelle une trace, pas une histoire
Un assistant annonce un devis puis explique qu’il a appliqué une remise. Si cette phrase ne correspond pas au moteur de tarification, elle crée une seconde erreur. Le client peut croire comprendre un calcul que le système n’a pas réellement effectué.
Séparez production du résultat et commentaire. Pour une opération déterministe, conservez les valeurs et la règle exécutée. Le modèle peut les reformuler, mais ne doit pas inventer les étapes manquantes.
Une citation visible n’est pas une vérification complète
Les travaux de Liu et ses collègues sur les moteurs génératifs de 2023 montrent que présence d’une citation et soutien effectif de l’affirmation diffèrent. Lee et See éclairent le rôle de la confiance dans le recours à l’automatisation. Le rapprochement appelle une explication contrôlable, pas simplement persuasive. (John D. Lee et al., 2004)(Liu et al., 2023)
Ces résultats historiques ne donnent pas le taux d’erreur d’un outil actuel. Ils justifient de tester le lien entre affirmation et preuve dans votre propre système.
Une justification plausible n’est pas une trace d’exécution
Les travaux de FactCC cherchent à rapprocher une affirmation des passages qui peuvent la soutenir dans un document. Ils ne prouvent pas qu’une explication générée reproduit le calcul interne d’un système. Cette distinction est centrale : un récit cohérent peut expliquer une réponse après coup sans fournir la preuve que la bonne règle a été appliquée. (Wojciech Kryscinski et al., 2020)
Pour un montant, affichez les données d’entrée, la formule déterministe et les arrondis. Pour une règle métier, donnez la version applicable et le passage concerné. Recalculez hors du modèle lorsque l’enjeu le nécessite. L’utilisateur doit pouvoir contester une donnée précise ; un long paragraphe convaincant lui donne peu de prise si aucun élément n’est reproductible.
Afficher ce qui permet de refaire ou contester le résultat
Pour un devis, montrez quantité, prix unitaire, remise, taxes applicables et version tarifaire selon le contexte. Pour une recommandation, montrez les contraintes et critères effectivement utilisés. Pour une synthèse, reliez les affirmations aux passages pertinents.
L’équipe métier valide la signification ; l’ingénierie garantit la provenance ; le design facilite la lecture. Évitez un panneau de détails si technique qu’aucun utilisateur visé ne peut l’exploiter.
Relier le commentaire aux champs du calcul
Pour un calcul métier, un format structuré peut contenir identifiant de règle, version tarifaire, entrées normalisées et résultat. Le texte explicatif est ensuite comparé à ces champs. Si le modèle mentionne une remise absente de la trace, la réponse doit être corrigée ou remplacée par une décomposition déterministe. Cette architecture est particulièrement utile dans un simulateur : elle permet de conserver une interface conversationnelle sans confier au modèle la vérité du prix. Les tests doivent couvrir les changements de quantité, de date et de profil de droits.
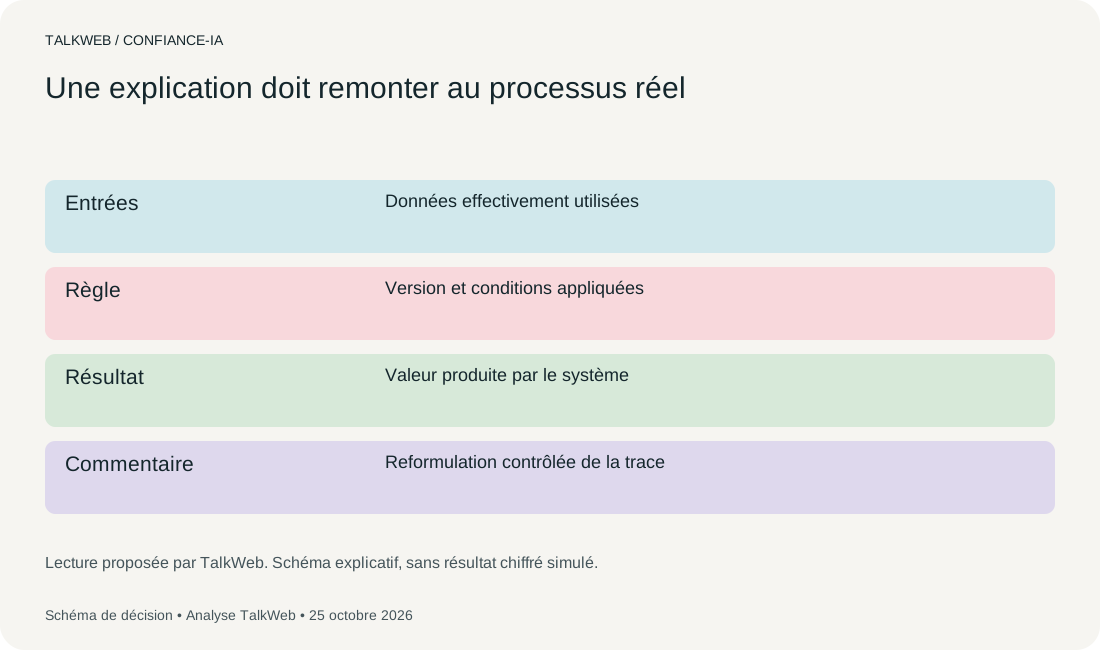
Lecture proposée par TalkWeb. Schéma explicatif, sans résultat chiffré simulé.
Télécharger le schéma SVG ↓Un simulateur calcule un prix avec un moteur de règles
Un simulateur calcule un prix avec un moteur de règles. Dans ce scénario fictif, le modèle rédige une explication à partir de la trace structurée. Une vérification compare les montants mentionnés aux valeurs calculées. Si le texte diverge, le service affiche la décomposition déterministe et ne présente pas la justification comme valide.
Tester une explication volontairement incohérente
Dans une recette isolée, préparez un résultat correct avec une mauvaise justification et l’inverse. Vérifiez si les contrôles et les personnes repèrent le décalage. Ne mesurez pas seulement la préférence pour le texte le plus clair.
Suivez les contestations résolues grâce à la trace et les écarts entre calcul et commentaire. Une explication utile réduit le coût de vérification et rend une correction possible.
Lorsque l’explication cite un document, il faut encore vérifier que la citation soutient la phrase affichée.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| Résultat | Conserver les données et règles | Ingénierie |
| Explication | La relier à la trace réelle | Produit |
| Contestation | Permettre une vérification lisible | Métier |
La décision à retenir
Exposez les éléments vérifiables du processus : données d’entrée, règle applicable, calcul ou source. Un texte généré qui semble logique ne prouve pas que le système a suivi ce raisonnement.
- Votre prochaine étape
- Comparer les explications générées à la trace de calcul sur des cas de recette.
- Comment juger le résultat
- Chaque affirmation importante est soutenue par un élément vérifiable.
Les limites de cette analyse
- Cadre conceptuel historique ; pas de score de fiabilité pour un modèle actuel.
- Deux dénominateurs distincts : phrases et citations.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
John D. Lee, & Katrina A. See. (2004). Trust in Automation: Designing for Appropriate Reliance. RECHERCHE · Human Factors.
DOI : 10.1518/hfes.46.1.50.30392 ↗Conclusion et cadre conceptuel du PDF auteur consultés ; revue théorique, pas essai de chatbot.
Voir la fiche de preuve
- Constat
- La confiance influence le recours à l’automatisation sans se confondre avec lui ni le déterminer seule.
- Localisateur
- Conclusion et cadre conceptuel du PDF auteur consultés ; revue théorique, pas essai de chatbot.
- Court extrait
- « Trust influences reliance on automation »
- Méthode
- RECHERCHE · Human Factors
- Population
- Population et périmètre précisés dans la lecture citée ; pas de mesure conduite par TalkWeb.
- Limites
- Cadre conceptuel historique ; pas de score de fiabilité pour un modèle actuel.
Liu, N., Zhang, T., & Liang, P. (2023). Evaluating Verifiability in Generative Search Engines. Findings of the Association for Computational Linguistics: EMNLP 2023.
DOI : 10.18653/v1/2023.findings-emnlp.467 ↗Période des données : Moteurs interrogés : février–mars 2023
Lecture ciblée : résumé, pages 7004–7005 et 7007 ; définitions, évaluation humaine et résultats.
Voir la fiche de preuve
- Constat
- Dans quatre moteurs évalués en 2023, 51,5 % des phrases sont entièrement soutenues par des citations et 74,5 % des citations soutiennent leur phrase.
- Localisateur
- Résumé ; définitions pp. 7004–7005 ; résultats p. 7007
- Court extrait
- « only 74.5% of citations support their associated sentence »
- Méthode
- Évaluation humaine de réponses de moteurs de recherche génératifs.
- Population
- Quatre moteurs ; 34 annotateurs ; collecte février–mars 2023.
- Limites
- Deux dénominateurs distincts : phrases et citations. Ne mesure pas les produits actuels ni la vérité de chaque affirmation.
Wojciech Kryscinski, Bryan McCann, Caiming Xiong, & Richard Socher. (2020). Evaluating the Factual Consistency of Abstractive Text Summarization. EMNLP.
DOI : 10.18653/v1/2020.emnlp-main.750 ↗Résumé primaire consulté ; texte intégral non audité.