Décrivez le périmètre testé, les versions, les tâches et les résultats observés. Un comparatif utile aux moteurs IA commence par une information utile et vérifiable pour l’acheteur, sans garantie de citation.
Marketing produit d’un éditeur SaaS
La décision à éclairer : Construire une comparaison crédible sans transformer des affirmations commerciales en résultats de test.
« Meilleur logiciel » ne répond pas à une décision d’achat complexe
Un acheteur B2B cherche souvent à savoir si un outil s’intègre à son environnement, gère ses droits et permet un parcours précis. Un tableau de coches sans conditions masque les différences de version, d’offre ou de paramétrage. La première tâche est de définir le cas d’usage et le niveau de preuve de chaque ligne.
Distinguez les fonctions documentées par l’éditeur, celles que vous avez testées et celles qui restent à confirmer. Une absence d’information publique n’est pas une absence de fonctionnalité. Pour un concurrent, indiquez la date et le périmètre de vérification plutôt que d’affirmer une incapacité générale.
Le GEO ne dispense pas de rendre la preuve inspectable
Le benchmark GEO étudie la visibilité de contenus dans des réponses génératives, pas les ventes d’un éditeur. Les travaux de Liu et ses coauteurs sur la vérifiabilité des moteurs génératifs montrent aussi que présence d’une citation et soutien effectif d’une affirmation ne sont pas équivalents. Ces résultats invitent à soigner le lien entre chaque conclusion et sa preuve. (Aggarwal et al., 2024)(Liu et al., 2023)
Nous ne déduisons pas de ces travaux qu’un tableau vous fera citer. Nous proposons une architecture lisible : question précise, méthode, observation, source et conséquence métier. Elle sert d’abord l’acheteur qui doit défendre son choix auprès de la DSI et des utilisateurs.
Le comparatif doit aider l’acheteur à défendre son choix en interne
Bettman, Luce et Payne décrivent un choix dépendant de la tâche et des informations disponibles. Ce cadre ne démontre pas un gain GEO. Il aide à concevoir un comparatif pour un achat B2B réel : la personne qui consulte la page devra souvent expliquer son choix à la DSI, aux utilisateurs et au responsable du budget. (James R. Bettman et al., 1998)
Présentez les scénarios testés, les limites de périmètre et les critères qui changent selon le contexte. Une intégration disponible n’est pas une intégration déployée sans effort. Donnez les éléments nécessaires à cette discussion interne, avec leurs sources et versions. Le lecteur doit pouvoir réutiliser votre comparaison sans transformer une appréciation locale en classement universel des logiciels.
Concevoir des tests que quelqu’un peut comprendre et refaire
Choisissez des tâches représentatives : créer un rôle limité, exporter un dossier, reprendre une erreur ou connecter un environnement de test. Décrivez la version, l’offre, les réglages et les conditions. Si le test n’a pas été exécuté, appelez-le protocole proposé, pas résultat.
Conservez les éléments vérifiables sans exposer de données privées : captures autorisées, journaux expurgés, étapes et documentation. Les scores composites doivent expliquer leur pondération. Une note globale calculée pour favoriser votre produit détruit la valeur du détail, même si chaque fonctionnalité est correctement décrite.
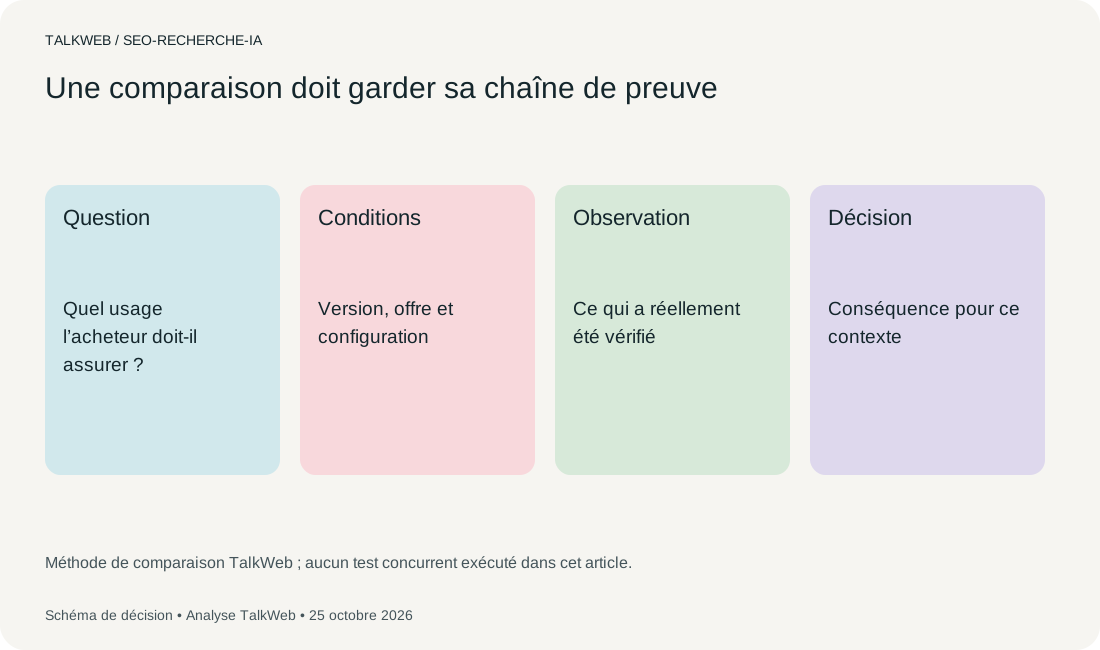
Méthode de comparaison TalkWeb ; aucun test concurrent exécuté dans cet article.
Télécharger le schéma SVG ↓Exemple : comparer l’export d’un dossier plutôt qu’une coche « export »
Dans un comparatif fictif de logiciels, deux solutions annoncent un export. Le test proposé précise le dossier, ses pièces, ses métadonnées et les droits du compte utilisé. Il examine ce qui sort réellement, dans quel format et avec quelles limites. Si TalkWeb n’exécute pas ce test, l’article le présente comme protocole et renvoie aux capacités documentées. Une coche unique aurait masqué ces différences. Le lecteur peut alors déterminer si l’export répond à son besoin de reprise ou d’archivage, plutôt que confondre la présence du mot avec la réalisation de son cas d’usage.
Mettre à jour les affirmations qui vieillissent vite
Les tarifs, limites et intégrations changent. Attribuez un responsable à chaque famille d’affirmations et une date de revue. Une mise à jour de la page doit conserver le sens du test ancien ou signaler clairement que le résultat ne concerne plus la version actuelle.
Le suivi GEO peut ensuite observer les citations et les erreurs de reprise, sans les confondre avec une preuve d’efficacité commerciale. L’article consacré à la mesure des citations propose ce prolongement. Une page solide est un actif vérifiable, pas une promesse de présence automatique dans les assistants.
Après publication, suivez les citations et recommandations de votre marque dans les réponses IA sans promettre qu’un comparatif sera repris.
Le comparatif s’inscrit dans un travail plus large : publier les informations B2B utiles aux réponses IA, en conservant des preuves vérifiables et une offre lisible.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| Fonction documentée | Lier la documentation et sa date | Produit |
| Résultat testé | Décrire version, tâche et conditions | Équipe de test |
| Point non vérifié | Le signaler sans conclure à une absence | Édition |
La décision à retenir
Décrivez le périmètre testé, les versions, les tâches et les résultats observés. Un comparatif utile aux moteurs IA commence par une information utile et vérifiable pour l’acheteur, sans garantie de citation.
- Votre prochaine étape
- Reprendre cinq lignes du comparatif et attribuer à chacune une source ou un protocole.
- Comment juger le résultat
- Chaque conclusion peut être vérifiée et son périmètre est compréhensible.
Les limites de cette analyse
- Moteurs et protocole de 2024.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. PUBLICATION SCIENTIFIQUE · KDD.
DOI : 10.1145/3637528.3671900 ↗Version du 28 juin 2024 ; lecture ciblée de la méthodologie, du protocole et des mesures de visibilité.
Voir la fiche de preuve
- Constat
- Le benchmark GEO mesure notamment la part de texte associée aux sources et sa position ; ce n’est pas une mesure de ventes.
- Localisateur
- Sections 2.2 et 3, métriques et protocole.
- Court extrait
- « position-adjusted word count »
- Méthode
- Benchmark expérimental de moteur génératif.
- Population
- 10 000 requêtes dans GEO-bench.
- Limites
- Moteurs et protocole de 2024. Pas une preuve de gain commercial sur les assistants actuels.
Liu, N., Zhang, T., & Liang, P. (2023). Evaluating Verifiability in Generative Search Engines. Findings of the Association for Computational Linguistics: EMNLP 2023.
DOI : 10.18653/v1/2023.findings-emnlp.467 ↗Période des données : Moteurs interrogés : février–mars 2023
Lecture ciblée : résumé, pages 7004–7005 et 7007 ; définitions, évaluation humaine et résultats.
Voir la fiche de preuve
- Constat
- Dans quatre moteurs évalués en 2023, 51,5 % des phrases sont entièrement soutenues par des citations et 74,5 % des citations soutiennent leur phrase.
- Localisateur
- Résumé ; définitions pp. 7004–7005 ; résultats p. 7007
- Court extrait
- « only 74.5% of citations support their associated sentence »
- Méthode
- Évaluation humaine de réponses de moteurs de recherche génératifs.
- Population
- Quatre moteurs ; 34 annotateurs ; collecte février–mars 2023.
- Limites
- Deux dénominateurs distincts : phrases et citations. Ne mesure pas les produits actuels ni la vérité de chaque affirmation.
James R. Bettman, Mary Frances Luce, & John W. Payne. (1998). Constructive Consumer Choice Processes. Journal of Consumer Research.
DOI : 10.1086/209535 ↗Résumé et introduction du PDF consultés.