Suivez séparément la présence de la marque, la citation d’une page, l’exactitude des informations et la recommandation pour le besoin exprimé. Conservez les réponses et répétez les requêtes. Un score global de visibilité ne doit pas masquer une recommandation inadaptée ou un prix faux.
Responsable SEO/GEO et marketing produit d’une entreprise B2B ou e-commerce.
La décision à éclairer : Choisir les contenus à améliorer et évaluer une prestation de visibilité dans les assistants.
Le nom de votre marque dans une réponse ne suffit pas
Un acheteur cherche un logiciel de gestion pour plusieurs entrepôts avec une contrainte d’hébergement. L’assistant mentionne votre produit, mais le présente comme réservé aux indépendants. Votre outil de veille compte une présence ; votre commercial voit une occasion perdue. Pour cette raison, il faut écrire les scénarios de recherche à partir des critères qui déclenchent ou excluent réellement un achat.
Interrogez les équipes avant de construire le panel : quels termes les prospects utilisent-ils, quelles intégrations demandent-ils, quels freins reviennent dans les démonstrations ? Incluez des cas où votre offre ne convient pas. Un protocole qui attend votre marque dans toutes les réponses récompenserait une recommandation commerciale trompeuse.
La recherche GEO mesure une visibilité, pas un revenu
Pranjal Aggarwal et ses coauteurs présentent à KDD 2024 un benchmark de 10 000 requêtes. Ils définissent notamment des mesures fondées sur la quantité de texte attribuée à une source et sa position dans la réponse. Leurs résultats concernent un protocole expérimental ; ils ne donnent pas un taux de transformation applicable à votre activité. (Aggarwal et al., 2024)
Nous en tirons une distinction opérationnelle : occuper une place dans le texte, être compris correctement et obtenir une demande commerciale sont trois résultats différents. Cette distinction permet d’évaluer le travail éditorial sans lui attribuer ce qu’il ne mesure pas.
Être mentionné ne signifie pas être choisi pour le bon motif
Le modèle de Friestad et Wright distingue la manière dont les personnes interprètent une tentative de persuasion. Il ne prédit pas la sélection de marques par un modèle. Il aide ici à poser la bonne question au reporting : quelle promesse la mention fait-elle comprendre au lecteur, au-delà de la simple présence du nom ? (Marian Friestad et al., 1994)
Pour chaque observation, notez le besoin exprimé, le rôle de la marque et l’exactitude des caractéristiques attribuées. Une citation favorable sur un usage que le produit ne couvre pas peut créer des demandes inutiles. Faites examiner quelques réponses par le commercial et le produit avant de conclure à un gain de visibilité utile. La mesure GEO doit préserver le sens de la recommandation.
| Observation | Exemple de contrôle | Décision éditoriale proposée |
|---|---|---|
| Mention | La marque apparaît-elle ? | Conserver le contexte avant d’interpréter |
| Citation | Le lien soutient-il la phrase ? | Corriger ou préciser la preuve sur la page |
| Exactitude | Prix et capacités sont-ils justes ? | Rechercher la source de la déformation |
| Adéquation | Le produit convient-il au besoin demandé ? | Clarifier usages, incompatibilités et conditions |
Décomposer la réponse avant de calculer un score
Le travail de Nelson Liu, Tianyi Zhang et Percy Liang sur quatre moteurs génératifs, avec des réponses collectées en février–mars 2023, distingue couverture des affirmations et qualité des citations. Leur moyenne de 74,5 % concerne les citations qui soutiennent l’énoncé associé. Elle n’évalue pas les assistants actuels ; elle aide à concevoir une vérification qui dépasse la présence d’un lien. (Liu et al., 2023)
Notre grille ci-dessous sépare les observations. Une réponse peut citer votre documentation tout en recommandant un concurrent, ou vous recommander en utilisant une information obsolète. Lisez le passage et ouvrez le document. La présence d’un domaine dans une extraction automatique ne suffit pas à juger le sens de la recommandation.
| Signal | Question à vérifier | Ce qu’il ne prouve pas |
|---|---|---|
| Mention | Le produit ou la marque apparaît-il ? | Une recommandation favorable |
| Citation | Une page identifiable est-elle liée ? | Que le passage soutient la réponse |
| Exactitude | Prix, capacités et conditions sont-ils justes ? | Que le lecteur choisira le produit |
| Adéquation | La recommandation respecte-t-elle les contraintes ? | Une visite ou une vente |
| Visite / demande | Un parcours observable rejoint-il le site ou le CRM ? | La totalité de l’influence des assistants |
Construire un panel que l’on peut réellement rejouer
Pour un pilote, choisissez par exemple 30 scénarios et trois formulations par scénario. Ces nombres sont une proposition de travail, pas une norme scientifique. Répétez les appels à plusieurs dates, dans les mêmes conditions de langue et de localisation. Enregistrez le produit testé, les options de recherche disponibles, la date et la réponse complète. Ne comparez pas une session personnalisée de vente avec une session vierge utilisée pour la référence.
Le dénominateur doit rester visible. « Présent dans 40 % des réponses » doit préciser combien de scénarios et de répétitions ont été observés. Les variantes d’un même scénario ne constituent pas autant de clients indépendants. Si vous utilisez un modèle pour annoter les réponses, faites contrôler un échantillon et les cas ambigus par un lecteur métier ; le juge automatique peut lui aussi mal interpréter une négation.
Archivez les résultats défavorables. Si vous ne gardez que la plus belle réponse de chaque assistant, vous constituez une galerie commerciale, pas une mesure. Pour choisir une action, regroupez les erreurs : source manquante, information périmée, condition invisible ou incompatibilité non expliquée. Chaque famille mène à un travail différent.
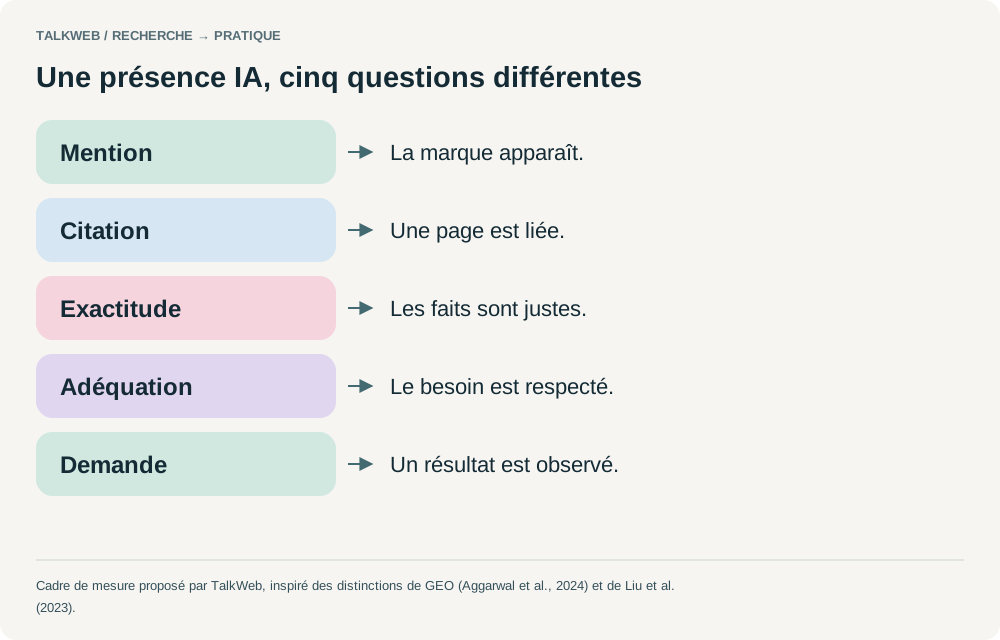
Modèle de mesure proposé par TalkWeb ; il ne représente pas un entonnoir de conversion mesuré.
Télécharger le schéma SVG ↓Exemple de désaccord utile entre marketing et commercial
Dans un cas fictif, une réponse recommande votre logiciel pour une PME qui exige un fonctionnement hors ligne. Votre site indique seulement « accès à vos données partout », ce que l’assistant interprète comme une disponibilité sans connexion. Le marketing reconnaît sa promesse ; le commercial sait que la fonction n’existe pas. L’erreur révèle une ambiguïté du contenu, même si le moteur participe à sa mauvaise interprétation.
La correction utile n’est pas d’ajouter dix fois « logiciel recommandé par les IA ». Elle consiste à décrire le fonctionnement réel, ses conditions et l’alternative éventuelle. Le marketing produit valide la réponse, le SEO s’assure que la page est accessible et la veille conserve des scénarios avec et sans cette contrainte. On vérifie alors si l’information erronée disparaît, pas seulement si la marque revient plus souvent.
Pour comparer deux prestataires de veille GEO, donnez-leur le même petit ensemble de scénarios et demandez les réponses brutes, les paramètres et la méthode de notation. Un score opaque peut être pratique pour suivre sa propre tendance, mais il ne permet pas de comparer deux méthodes. La capacité à expliquer une divergence sur un cas métier est un meilleur critère de sélection qu’un tableau de bord très coloré.
Corriger une information vérifiable, puis observer sa reprise
Pour une offre B2B, commencez par une page de référence : fonctions réellement disponibles, limites de l’offre, compatibilités, conditions et date de mise à jour. Réconciliez cette page avec les comparatifs, les fiches partenaires et les documents accessibles. Une reformulation séduisante ne suffit pas si vos propres pages se contredisent.
Google précise qu’aucun balisage Schema.org spécial ni fichier IA supplémentaire n’est nécessaire pour ses fonctionnalités IA. Les fondations de visibilité et la cohérence du contenu restent pertinentes. Cette documentation décrit Google ; elle ne constitue pas une garantie universelle de citation dans tous les assistants. Documentation de l’outil ↗
Après correction, rejouez le panel et vérifiez les erreurs ciblées, en conservant les réponses non améliorées. Une hausse de mentions peut accompagner une évolution du moteur ou de ses sources. Présentez donc les changements observés et les actions réalisées séparément. Pour mesurer l’effet commercial, ajoutez les visites identifiables et les demandes qualifiées, sans prétendre retrouver tous les parcours invisibles.
Si la correction concerne les données du site, organisez la cohérence du JSON-LD entre marketing et DSI pour éviter que l’ancienne information reste générée par le template.
Documentation & terrain
Google — fonctionnalités IA ↗
Exigences de visibilité dans les fonctionnalités IA de Google.
La décision à retenir
Le bon tableau de bord GEO distingue présence, exactitude, adéquation et résultat commercial. Il vous aide à choisir une correction précise.
- Votre prochaine étape
- Prendre dix questions issues des échanges commerciaux et annoter les réponses avec le marketing produit.
- Comment juger le résultat
- Chaque résultat renvoie à une réponse archivée, à un scénario explicite et à un nombre d’observations ; les informations fausses ont un responsable de correction.
Les limites de cette analyse
- Deux dénominateurs distincts : phrases et citations.
- Ne mesure pas les produits actuels ni la vérité de chaque affirmation.
- Moteurs et protocole de 2024.
- Pas une preuve de gain commercial sur les assistants actuels.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. PUBLICATION SCIENTIFIQUE · KDD.
DOI : 10.1145/3637528.3671900 ↗Version du 28 juin 2024 ; lecture ciblée de la méthodologie, du protocole et des mesures de visibilité.
Voir la fiche de preuve
- Constat
- Le benchmark GEO mesure notamment la part de texte associée aux sources et sa position ; ce n’est pas une mesure de ventes.
- Localisateur
- Sections 2.2 et 3, métriques et protocole.
- Court extrait
- « position-adjusted word count »
- Méthode
- Benchmark expérimental de moteur génératif.
- Population
- 10 000 requêtes dans GEO-bench.
- Limites
- Moteurs et protocole de 2024. Pas une preuve de gain commercial sur les assistants actuels.
Liu, N., Zhang, T., & Liang, P. (2023). Evaluating Verifiability in Generative Search Engines. Findings of the Association for Computational Linguistics: EMNLP 2023.
DOI : 10.18653/v1/2023.findings-emnlp.467 ↗Période des données : Moteurs interrogés : février–mars 2023
Lecture ciblée : résumé, pages 7004–7005 et 7007 ; définitions, évaluation humaine et résultats.
Voir la fiche de preuve
- Constat
- Dans quatre moteurs évalués en 2023, 51,5 % des phrases sont entièrement soutenues par des citations et 74,5 % des citations soutiennent leur phrase.
- Localisateur
- Résumé ; définitions pp. 7004–7005 ; résultats p. 7007
- Court extrait
- « only 74.5% of citations support their associated sentence »
- Méthode
- Évaluation humaine de réponses de moteurs de recherche génératifs.
- Population
- Quatre moteurs ; 34 annotateurs ; collecte février–mars 2023.
- Limites
- Deux dénominateurs distincts : phrases et citations. Ne mesure pas les produits actuels ni la vérité de chaque affirmation.
Marian Friestad, & Peter Wright. (1994). The Persuasion Knowledge Model: How People Cope with Persuasion Attempts. Journal of Consumer Research.
DOI : 10.1086/209380 ↗Résumé primaire consulté ; texte intégral non audité.