Demandez une précision lorsqu’une ambiguïté peut produire une mauvaise réponse importante. Proposez des choix courts et un accès aux résultats plutôt qu’un interrogatoire systématique.
Responsable recherche sur site et équipe produit
La décision à éclairer : Annoter les requêtes ambiguës les plus fréquentes avec le support.
Un portail industriel reçoit « batterie 24 V »
Un portail industriel reçoit « batterie 24 V ». Dans le scénario fictif, plusieurs technologies sont incompatibles avec certains équipements. Le moteur demande la référence de machine ou propose deux familles explicites. Il ne déduit pas la compatibilité de la tension seule et laisse accéder à la recherche de référence.
Une réponse rapide à la mauvaise question reste un échec
Dans une base de connaissances, « export » peut concerner les contacts, les factures ou les droits d’accès. Un assistant qui choisit sans le dire peut fournir une procédure exacte pour le mauvais objet. Le défaut vient du cadrage, pas nécessairement de la rédaction.
Identifiez les requêtes qui conduisent à des reformulations ou à des retours immédiats. Vérifiez si le contexte de page permet déjà de lever l’ambiguïté. Ne redemandez pas une information que le visiteur vient de préciser.
Deux personnes peuvent chercher la même chose avec des mots différents
Furnas et ses collègues montrent, dans cinq domaines, les difficultés d’un vocabulaire unique choisi par le concepteur. Clark et Brennan analysent le travail de clarification nécessaire pour établir une compréhension commune. Ces travaux ne fixent pas le nombre optimal de questions d’un moteur moderne ; ils expliquent pourquoi une requête apparemment imprécise peut être parfaitement naturelle pour le visiteur. (George W. Furnas et al., 1987)(Herbert H. Clark et al., 1991)
Avant d’interrompre la recherche, vérifiez si les synonymes et les catégories d’usage suffisent. Demandez une précision seulement lorsqu’elle modifie vraiment les résultats : « pour quel matériau ? » est utile si la compatibilité en dépend. Montrez ce que la réponse permettra de distinguer et laissez une voie d’exploration. Une clarification doit réduire l’incertitude, pas faire subir au client les lacunes de votre index.
L’incertitude doit modifier l’interaction
Les recommandations humain-IA d’Amershi et ses collègues traitent notamment la gestion des erreurs et du contrôle. RAGAS sépare pertinence du contexte et qualité de réponse. Notre application : avant de générer, vérifier si plusieurs intentions plausibles conduisent à des actions différentes. (Saleema Amershi et al., 2019)(Shahul Es et al., 2024)
Un score de similarité du moteur ne représente pas automatiquement une probabilité de comprendre le besoin. Calibrez les règles sur des exemples annotés par le métier et gardez une possibilité de recherche classique.
Poser la question qui réduit réellement le risque
Préférez « Vous voulez exporter les contacts ou les factures ? » à « Pouvez-vous préciser ? ». Montrez pourquoi la distinction compte si nécessaire. Pour une recherche de référence, proposez directement les correspondances exactes plutôt qu’une conversation obligatoire.
L’équipe search peut définir des familles d’intentions ; le support apporte les confusions récurrentes ; le produit fixe les cas où une mauvaise orientation est coûteuse. Une question de clarification doit faire partie du parcours testé, pas d’un prompt laissé à l’improvisation.
Conserver une intention sans figer toute la conversation
Conservez les choix de clarification sous une forme exploitable par le moteur, pas seulement dans l’historique libre de la conversation. Une intention confirmée peut filtrer un domaine documentaire ou une famille de produits. Si l’utilisateur change ensuite de sujet, retirez les filtres devenus inadaptés et rendez ce changement visible. La recette doit inclure ces transitions : un contexte ancien conservé trop longtemps peut produire une réponse très précise à une demande qui n’est plus la bonne. L’historique aide uniquement si sa portée est maîtrisée.
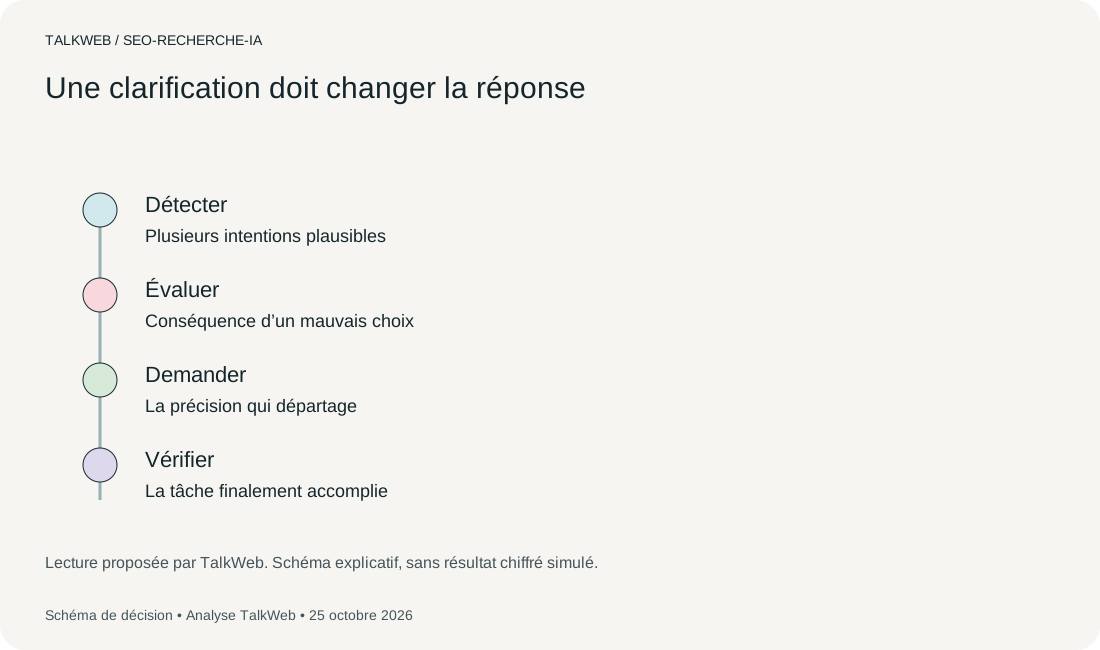
Lecture proposée par TalkWeb. Schéma explicatif, sans résultat chiffré simulé.
Télécharger le schéma SVG ↓Mesurer la suite de la clarification
Suivez réponses à la question, résultat choisi, reformulations et abandon. Un bon taux de réponse à la clarification ne prouve pas que la procédure trouvée est la bonne. Vérifiez l’accomplissement de la tâche lorsque c’est observable.
Si la question est souvent ignorée, examinez son vocabulaire et son utilité. Il peut être préférable de montrer deux groupes de résultats clairement nommés plutôt que de bloquer la recherche.
Si la recherche alimente un assistant, séparez les erreurs de récupération documentaire des erreurs de génération avant de modifier le moteur.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| Ambiguïté sans conséquence | Présenter les groupes de résultats | Search |
| Actions différentes | Demander une précision ciblée | Produit |
| Compatibilité critique | Vérifier la référence | Expert métier |
La décision à retenir
Demandez une précision lorsqu’une ambiguïté peut produire une mauvaise réponse importante. Proposez des choix courts et un accès aux résultats plutôt qu’un interrogatoire systématique.
- Votre prochaine étape
- Annoter les requêtes ambiguës les plus fréquentes avec le support.
- Comment juger le résultat
- Les clarifications réduisent les mauvaises orientations sans bloquer les recherches simples.
Les limites de cette analyse
- Validation de recommandations, pas estimation d’un gain commercial.
- Un juge automatique peut lui-même se tromper ; validation humaine requise.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
Saleema Amershi, Dan Weld, Mihaela Vorvoreanu, Adam Fourney, Besmira Nushi, Penny Collisson, Jina Suh, Shamsi Iqbal, Paul Bennett, Kori Inkpen, Jaime Teevan, Ruth Kikin-Gil, & Eric Horvitz. (2019). Guidelines for Human-AI Interaction. RECHERCHE · CHI.
Publication originale ↗Résumé et fiche de recherche Microsoft consultés ; 18 lignes directrices, validation par 49 praticiens sur 20 produits.
Voir la fiche de preuve
- Constat
- Le travail propose et évalue des recommandations d’interaction humain-IA.
- Localisateur
- Résumé et fiche de recherche Microsoft consultés ; 18 lignes directrices, validation par 49 praticiens sur 20 produits.
- Court extrait
- « Guidelines for Human-AI Interaction »
- Méthode
- Conception et évaluation de recommandations d’interaction.
- Population
- 49 praticiens sur 20 produits IA ; 18 recommandations.
- Limites
- Validation de recommandations, pas estimation d’un gain commercial.
Shahul Es, Jithin James, Luis Espinosa-Anke, & Steven Schockaert. (2024). RAGAS: Automated Evaluation of Retrieval Augmented Generation. RECHERCHE · EACL.
DOI : 10.18653/v1/2024.eacl-demo.16 ↗PDF consulté ; résumé et description de la décomposition de l’évaluation.
Voir la fiche de preuve
- Constat
- L’évaluation distingue notamment la qualité du contexte récupéré, la fidélité de la réponse et sa pertinence.
- Localisateur
- PDF consulté ; résumé et description de la décomposition de l’évaluation.
- Court extrait
- « RAGAS: Automated Evaluation of Retrieval Augmented Generation »
- Méthode
- RECHERCHE · EACL
- Population
- Population et périmètre précisés dans la lecture citée ; pas de mesure conduite par TalkWeb.
- Limites
- Un juge automatique peut lui-même se tromper ; validation humaine requise.
George W. Furnas, Thomas K. Landauer, Louis M. Gomez, & Susan T. Dumais. (1987). The Vocabulary Problem in Human-System Communication. Communications of the ACM.
DOI : 10.1145/32206.32212 ↗Résumé et introduction du PDF consultés.
Herbert H. Clark, & Susan E. Brennan. (1991). Grounding in Communication. Perspectives on Socially Shared Cognition.
DOI : 10.1037/10096-006 ↗Introduction et conclusion du chapitre consultées ; cadre conceptuel, pas mesure des chatbots.