Ne vous fiez pas au nom déclaré dans le User-Agent. Vérifiez l’origine avec les méthodes documentées et appliquez ensuite une politique par route et usage, sans ouvrir tout le site à un simple libellé.
Responsable sécurité, administrateur WAF et SEO technique
La décision à éclairer : Distinguer identification du robot et autorisation d’accès.
Le nom envoyé par la requête n’est pas une identité
Un client HTTP peut déclarer un User-Agent connu. Une règle « autoriser si le texte contient Googlebot » devient donc une permission facile à imiter. Le problème concerne autant la sécurité que la visibilité : une exception trop large ouvre des routes qui n’ont aucun intérêt pour l’indexation.
Inventoriez les routes publiques, les API, les pages de connexion et les espaces authentifiés. Un robot utile pour découvrir les contenus publics n’a pas besoin de contourner les protections d’un compte client. L’identité et l’usage attendu doivent rester deux décisions séparées.
Google documente des vérifications d’origine
La documentation Google décrit notamment la vérification par plages IP publiées ou par résolution DNS inverse puis directe. Le retour direct doit correspondre à l’adresse initiale selon la méthode documentée ; un nom ressemblant à un domaine connu ne suffit pas. Le rapport DataDome éclaire de son côté un contexte de trafic automatisé sur son propre périmètre client. (Google, 2026)(DataDome, 2026)
Nous n’en déduisons pas que tous les robots sont malveillants ni que les statistiques d’un fournisseur décrivent tout le web. L’action utile est de vérifier la chaîne de confiance de votre installation, y compris la manière dont l’adresse du client est transmise derrière un proxy.
L’identité vérifiée n’accorde pas tous les droits
Saltzer et Schroeder exposent notamment les principes de moindre privilège et de vérification des accès. Ce texte fondateur ne décrit pas les méthodes actuelles d’identification de Googlebot ; la documentation Google reste nécessaire pour cela. Il fournit en revanche la logique qui évite une erreur de politique : reconnaître un visiteur ne signifie pas lui autoriser toutes les opérations. (Jerome H. Saltzer et al., 1975)
Après vérification de l’origine, appliquez toujours les restrictions liées aux routes, aux méthodes HTTP et à la sensibilité des données. Un robot légitime peut lire une page publique sans avoir à atteindre un export client. Testez les exceptions sur une liste de parcours et conservez les refus utiles dans les journaux. La règle doit pouvoir être expliquée par son besoin, pas seulement par une réputation de fournisseur.
Mettre la règle au bon endroit dans l’infrastructure
Dans DataDome ou un autre dispositif WAF, commencez par les classifications et fonctions effectivement disponibles dans votre contrat et votre configuration. N’ajoutez pas une exception générale en réaction à une baisse SEO sans analyser les journaux. Vérifiez les résultats sur les routes et les catégories de robots concernées.
Si une vérification est développée en interne, l’équipe sécurité doit gérer mises à jour, cache, échecs de résolution et provenance fiable de l’IP. Les en-têtes transmis par un client ne doivent pas être considérés comme une identité fiable sans la chaîne de proxies appropriée.
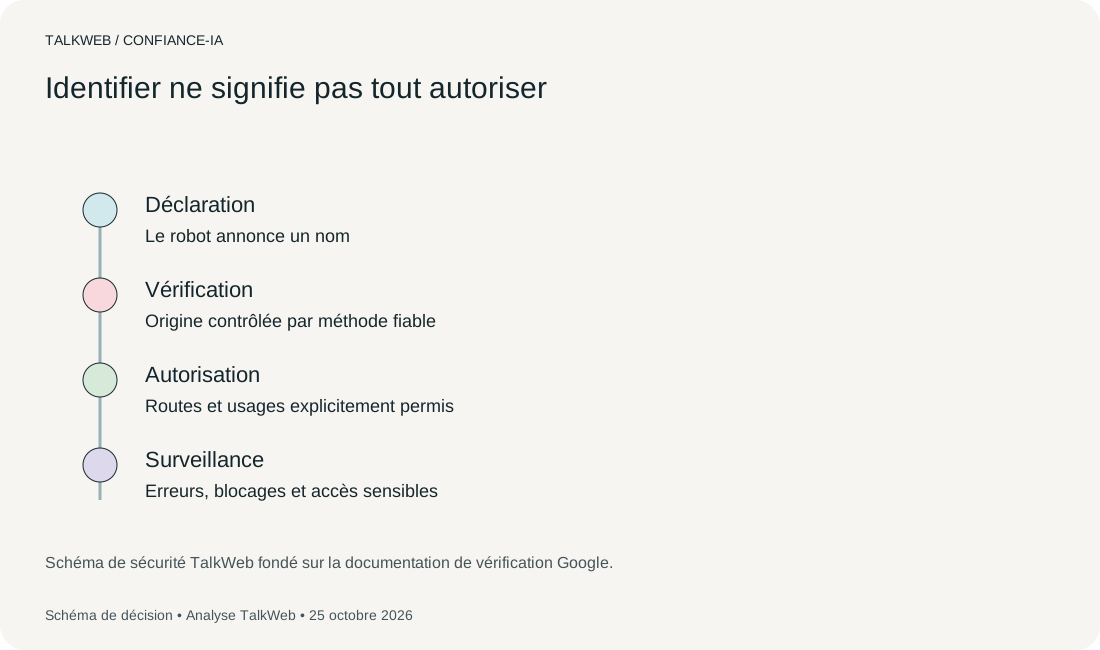
Schéma de sécurité TalkWeb fondé sur la documentation de vérification Google.
Télécharger le schéma SVG ↓Exemple : une exception de robot appliquée aux routes de connexion
Une configuration fictive autorise un User-Agent connu sur tout le domaine. La revue découvre que l’exception couvre aussi des routes de connexion. L’équipe sépare alors la vérification d’origine et la politique d’accès par usage. Elle teste une requête usurpée, une requête vérifiée vers un contenu public et une requête vers une route sensible. Les résultats sont relus avec le SEO pour préserver la découverte des contenus utiles. Cette recette ne cherche pas à contourner le WAF : elle vérifie que les règles correspondent aux accès réellement souhaités.
Contrôler les effets côté sécurité et côté découverte
Après changement, examinez les requêtes autorisées et bloquées, les erreurs d’exploration et les routes sensibles. Un test doit inclure un User-Agent usurpé et un robot vérifié sur une route publique. La règle doit échouer proprement lorsque la vérification n’est pas disponible, selon la politique de risque définie.
Le SEO et la sécurité doivent partager les catégories et les objectifs, pas seulement un taux global de blocage.
Une fois l’identité vérifiée, décidez quels usages des robots IA autoriser ou bloquer en fonction de leur rôle et du parcours concerné.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| User-Agent connu | Ne pas l’utiliser comme preuve suffisante | Sécurité |
| Origine vérifiée | Autoriser seulement les usages prévus | WAF / exploitation |
| Baisse de crawl | Analyser routes et journaux avant exception | SEO / sécurité |
La décision à retenir
Ne vous fiez pas au nom déclaré dans le User-Agent. Vérifiez l’origine avec les méthodes documentées et appliquez ensuite une politique par route et usage, sans ouvrir tout le site à un simple libellé.
- Votre prochaine étape
- Auditer les exceptions de robots et tester un User-Agent usurpé dans un environnement contrôlé.
- Comment juger le résultat
- Les robots utiles accèdent aux contenus prévus sans exception fondée sur leur seul nom.
Les limites de cette analyse
- Documentation d’éditeur évolutive ; ne démontre pas une hausse du trafic ou du chiffre d’affaires.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
Google. (2026). Verifying Googlebot and other Google crawlers. DOCUMENTATION · Google.
Publication originale ↗Documentation publique consultée le 25 octobre 2026 ; portée fonctionnelle, sans test d’intégration réalisé par TalkWeb.
Voir la fiche de preuve
- Constat
- La vérification utilise notamment les plages IP publiées ou une résolution DNS inverse puis directe.
- Localisateur
- Documentation publique consultée le 25 octobre 2026 ; portée fonctionnelle, sans test d’intégration réalisé par TalkWeb.
- Court extrait
- « Verifying Googlebot and other Google crawlers »
- Méthode
- DOCUMENTATION · Google
- Population
- Population et périmètre précisés dans la lecture citée ; pas de mesure conduite par TalkWeb.
- Limites
- Documentation d’éditeur évolutive ; ne démontre pas une hausse du trafic ou du chiffre d’affaires.
DataDome. (2026). State of Bot & Agent Security Report 2026. ÉTUDE FOURNISSEUR · DataDome.
Publication originale ↗Période des données : Juillet 2025 à juin 2026 pour la télémétrie annuelle ; certaines analyses ont une autre fenêtre.
Synthèse publique et méthodologie affichée consultées ; données brutes et rapport complet non audités.
Voir la fiche de preuve
- Constat
- DataDome rapporte 52,7 milliards de requêtes d’agents IA et de crawlers LLM sur sa clientèle en douze mois.
- Localisateur
- Key findings ; AI traffic is moving from passive crawling into active user journeys.
- Court extrait
- « 52.7 billion »
- Méthode
- Télémétrie propriétaire.
- Population
- Plus de 75 000 sites clients.
- Limites
- Échantillon fournisseur, pas tout Internet. Classification et données brutes non auditées.
Jerome H. Saltzer, & Michael D. Schroeder. (1975). The Protection of Information in Computer Systems. Proceedings of the IEEE.
Publication originale ↗Résumé et passages sur contrôle d’accès, authentification et principaux responsables consultés.