Ne remplacez pas un contrôle défini par l’étiquette « expert ». Vérifiez que la personne dispose du contexte, des sources et du temps nécessaires pour détecter les erreurs du système.
Responsable qualité, formation et déploiement IA
La décision à éclairer : Observer une validation réelle avec les sources et contraintes habituelles.
Connaître le métier ne suffit pas lorsque l’information manque
Un spécialiste peut repérer une règle incohérente mais ignorer qu’un document a changé hier. Il peut aussi accepter une réponse plausible sous contrainte de délai. La compétence et les conditions de vérification doivent être examinées ensemble.
Décrivez ce que le contrôle exige : retrouver une donnée, refaire un calcul, comparer une version ou connaître une exception. Si l’interface cache ces éléments, elle rend le travail de l’expert inutilement difficile.
L’assistance peut déplacer l’effort de raisonnement
L’étude de Buçinca et ses collègues montre l’intérêt de dispositifs qui encouragent une réflexion avant de suivre l’IA. Les résultats sur la frontière technologique rappellent que les tâches ne sont pas toutes également assistables. Cela ne prouve pas que tout expert sera trompé ; cela interdit de considérer sa présence comme une garantie suffisante. (Zana Buçinca et al., 2021)(Dell’Acqua et al., 2026)
La bonne question devient : quelles erreurs cette personne peut-elle effectivement reconnaître dans ce parcours précis ?
L’expert peut manquer de temps autant que de connaissances
L’enquête de Lee et ses collègues rapporte des obstacles à l’examen critique des sorties d’IA, dont le temps disponible et la difficulté à inspecter la réponse. Il ne s’agit pas d’un test objectif des experts. Ce constat complète néanmoins les expériences de décision assistée : savoir vérifier et disposer des conditions pour le faire sont deux choses différentes. (Hao-Ping Lee et al., 2025)
Pour une validation métier, fournissez les données d’origine, les hypothèses et les points modifiés par l’assistant. Réservez une vérification indépendante aux conséquences importantes. Un expert sollicité entre deux réunions sur un texte déjà présenté comme final risque de contrôler le style plutôt que le fond. Organisez la revue avant que le résultat ne devienne un engagement auprès du client.
Évaluer avec des erreurs proches du travail réel
Préparez des cas corrects, incomplets et faux mais plausibles. Ne glissez pas uniquement des erreurs grossières qui donnent une fausse impression de maîtrise. Faites valider les références et la gravité par le métier.
Observez la procédure de contrôle, le temps et les éléments consultés. Une bonne réponse finale obtenue par hasard n’est pas une compétence de vérification démontrée. Inversement, une hésitation argumentée peut être un signe de contrôle utile.
Réduire le coût pratique de la vérification
Prévoyez un accès aux preuves qui corresponde au rythme du travail. Si retrouver la règle demande plusieurs applications et une recherche manuelle longue, le contrôle risque d’être contourné malgré la compétence. Mesurez ce coût de vérification et simplifiez-le sans supprimer la possibilité de contradiction. Une source ouverte au bon passage, une version visible ou un calcul décomposé peuvent être plus utiles qu’un rappel général de vigilance. Le responsable du processus doit aussi décider ce qui se passe lorsqu’un expert signale un doute non résolu.
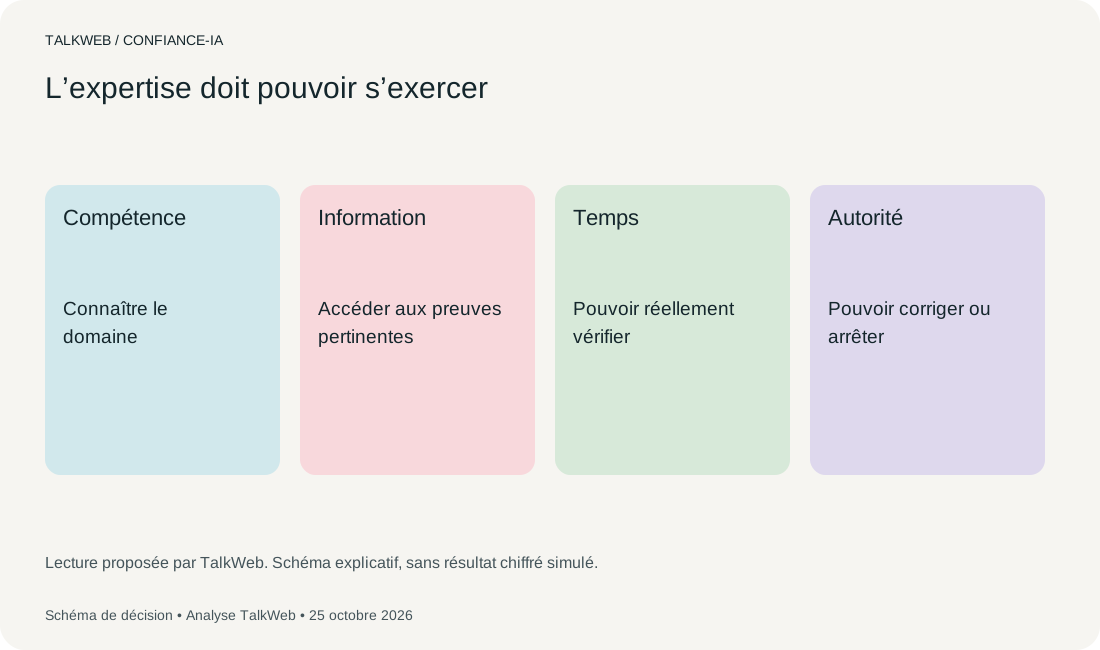
Lecture proposée par TalkWeb. Schéma explicatif, sans résultat chiffré simulé.
Télécharger le schéma SVG ↓Une équipe de gestion vérifie des réponses sur des procédures
Une équipe de gestion vérifie des réponses sur des procédures. Dans le scénario fictif, les experts repèrent les erreurs de raisonnement mais pas une version périmée non signalée. L’équipe ajoute version et date d’application près de la citation, puis refait le test. Elle traite le défaut d’accès au contexte plutôt que d’accuser un manque d’attention.
Organiser une responsabilité praticable
Attribuez le contrôle à une personne qui possède l’autorité et les moyens d’arrêter ou de corriger. Prévoyez un second niveau pour les cas hors expertise. « Validation humaine » ne doit pas désigner un clic obligatoire sans accès aux preuves.
Suivez les erreurs manquées par type et améliorez l’interface ou la formation. L’objectif est de soutenir le jugement professionnel, pas de chercher un responsable humain pour chaque défaut du système.
La compétence ne suffit pas sans responsabilités explicites de supervision humaine, notamment pour refuser ou faire corriger une réponse.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| Erreur plausible | Tester une détection réelle | Qualité |
| Contexte manquant | Le rendre accessible | Produit |
| Hors expertise | Prévoir un second niveau | Métier |
La décision à retenir
Ne remplacez pas un contrôle défini par l’étiquette « expert ». Vérifiez que la personne dispose du contexte, des sources et du temps nécessaires pour détecter les erreurs du système.
- Votre prochaine étape
- Observer une validation réelle avec les sources et contraintes habituelles.
- Comment juger le résultat
- Le contrôle détecte les erreurs importantes et dispose d’une issue praticable.
Les limites de cette analyse
- Tâches expérimentales ; les contraintes ajoutées peuvent réduire l’acceptabilité.
- Tâche construite pour tester les limites du modèle.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
Zana Buçinca, Maja Barbara Malaya, & Krzysztof Z. Gajos. (2021). To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making. RECHERCHE · CSCW.
Publication originale ↗PDF ouvert ; résumé, dispositif et discussion des fonctions de forçage cognitif.
Voir la fiche de preuve
- Constat
- L’expérience avec 199 participants observe une réduction de la dépendance excessive dans certaines conditions de forçage cognitif.
- Localisateur
- PDF ouvert ; résumé, dispositif et discussion des fonctions de forçage cognitif.
- Court extrait
- « To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making »
- Méthode
- Expérience comparant plusieurs modalités d’assistance et fonctions de forçage cognitif.
- Population
- 199 participants aux tâches expérimentales.
- Limites
- Tâches expérimentales ; les contraintes ajoutées peuvent réduire l’acceptabilité.
Dell’Acqua, F., McFowland, E., Mollick, E., Lifshitz, H., Kellogg, K. C., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality. Organization Science.
DOI : 10.1287/orsc.2025.21838 ↗Période des données : Expérience : avril 2023 (publication finale en 2026)
Lecture ciblée de la publication 2026 : pages PDF 1–3, 6–9 et 11–12, notamment tableaux 2 et 7. Expérience menée avec GPT-4 en 2023.
Voir la fiche de preuve
- Constat
- Sur la tâche hors frontière étudiée, les proportions de réponses correctes sont environ 84 %, 71 % et 60 % selon les conditions.
- Localisateur
- Publication 2026, tableau 2 : proportions arrondies .84/.71/.60 ; tableau 7 pour l’estimation.
- Court extrait
- « outside the frontier »
- Méthode
- Expérience de terrain randomisée ; tâches de conseil, GPT-4 de 2023.
- Population
- 373 consultants dans le volet hors frontière ; 758 dans l’expérience entière.
- Limites
- Tâche construite pour tester les limites du modèle. Les chiffres du tableau 2 sont arrondis ; ne pas les convertir en effets universels.
Hao-Ping Lee, Advait Sarkar, Lev Tankelevitch, Ian Drosos, Sean Rintel, Richard Banks, & Nicholas Wilson. (2025). The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers. CHI.
DOI : 10.1145/3706598.3713778 ↗Lecture ciblée du PDF : résumé et résultats qualitatifs sur les motivations et obstacles à la vérification, sections 4.3 et 5 ; pas d’audit des analyses statistiques.