Cherchez d’abord si les études mesurent réellement la même chose. Un gain sur une tâche et une perte sur une autre peuvent décrire une frontière d’usage plutôt qu’une contradiction.
Responsable innovation, produit et analyse
La décision à éclairer : Comparer deux études dans une matrice avant de rédiger leur synthèse.
« L’IA fait gagner du temps » est une question trop large
Le support client, la rédaction et la maintenance d’un grand dépôt logiciel ne demandent pas les mêmes opérations. Leur qualité ne se vérifie pas de la même façon. Additionner leurs résultats dans une moyenne improvisée produit une précision sans signification.
Construisez une matrice : tâche, expérience des participants, outil, période, contrôle disponible et résultat mesuré. Les écarts deviennent souvent plus compréhensibles avant même de discuter des chiffres.
Des résultats différents peuvent être compatibles
METR observe un ralentissement sur des tâches de développeurs expérimentés dans son essai de début 2025. L’étude publiée sur le support client observe un gain moyen de résolution. Le travail sur la frontière technologique distingue aussi des tâches plus ou moins adaptées à l’assistance. (Becker et al., 2025)(Erik Brynjolfsson et al., 2025)(Dell’Acqua et al., 2026)
Ces travaux ne permettent pas de déclarer un vainqueur universel. Ils suggèrent de situer votre processus : connaissance préalable du dossier, difficulté de vérification, dépendances et qualité attendue. La date de publication doit rester distincte de la date des outils testés.
Comparer les mesures avant de comparer les pourcentages
Le cadre SPACE distingue plusieurs dimensions de la productivité des développeurs. Il aide à comprendre pourquoi un temps de tâche, une quantité de code et un résultat de service ne sont pas interchangeables. Deux études peuvent donc fournir des résultats différents sans répondre à la même question. (Nicole Forsgren et al., 2021)
Construisez une fiche par étude : population, tâche, outil, comparaison, résultat et durée d’observation. Repérez ensuite le point qui ressemble à votre situation. Si les populations ou les tâches diffèrent, formulez une hypothèse de transfert à tester au lieu de calculer une moyenne de leurs effets. Une contradiction réelle doit être examinée ; une différence de périmètre doit être conservée, car elle peut justement indiquer où l’usage devient utile ou coûteux.
| Élément | À conserver pour chaque étude |
|---|---|
| Population | Expérience, métier et mode de sélection |
| Tâche | Nature du travail et contexte de réalisation |
| Comparaison | Sans outil, autre outil ou évolution dans le temps |
| Résultat | Unité, durée et éventuelles conséquences non mesurées |
| Transfert | Ressemblances et différences avec votre situation |
Une DSI hésite entre une étude positive sur le support et une étude négative sur le code
Une DSI hésite entre une étude positive sur le support et une étude négative sur le code. Dans ce scénario fictif, elle ne les moyenne pas. Elle sélectionne des tâches de maintenance, définit une livraison revue et mesure les reprises. Les résultats du support restent un contexte, pas une estimation du gain attendu sur ses développeurs.
Transformer le désaccord en protocole local
Choisissez une famille de tâches et un résultat métier. Comparez durée complète, qualité et travail de reprise. Gardez la même définition du « terminé » dans les deux conditions. Un brouillon généré et un livrable validé ne sont pas des unités comparables.
Préparez aussi les conditions dans lesquelles vous n’adopterez pas l’outil : coût de contrôle, erreurs importantes ou déplacement de charge vers une autre équipe. Ce seuil doit être discuté avant de voir les résultats.
Attribuer un rôle précis à chaque type de preuve
La matrice doit aussi inclure la qualité de la preuve : expérience contrôlée, observation, entretien, benchmark ou documentation. Une étude qualitative peut expliquer un mécanisme sans mesurer sa fréquence ; un benchmark peut comparer des systèmes sans décrire leur adoption réelle. Ne les classez pas simplement de « bonne » à « mauvaise » : demandez à quelle partie de votre question chacune répond. Le dossier devient plus solide lorsque les sources se complètent explicitement, et plus trompeur lorsqu’elles sont présentées comme plusieurs votes sur une seule conclusion.
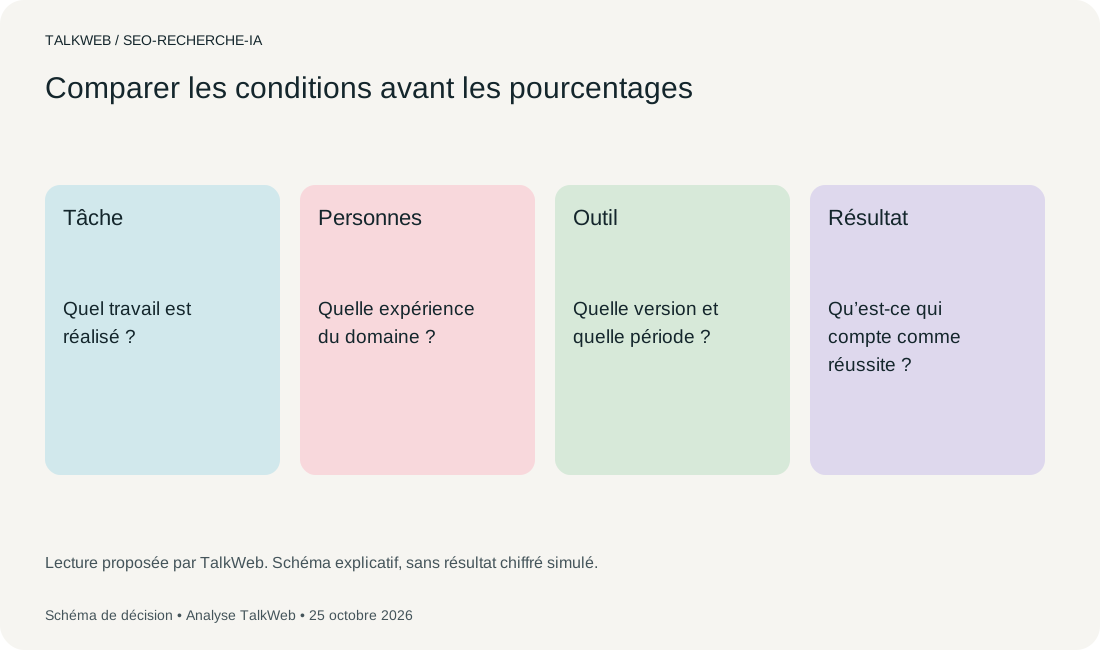
Lecture proposée par TalkWeb. Schéma explicatif, sans résultat chiffré simulé.
Télécharger le schéma SVG ↓Rédiger une conclusion proportionnée
Dites quel usage paraît soutenu, lequel reste incertain et quelle observation changerait votre décision. Évitez le faux équilibre : une expérience solide et un témoignage commercial ne pèsent pas pareil simplement parce qu’ils disent des choses opposées.
La bonne synthèse ne gomme pas le désaccord. Elle aide le lecteur à reconnaître son propre cas et à choisir une prochaine action mesurable. C’est plus utile qu’un verdict général « pour » ou « contre » l’IA.
Dans le développement, traduisez l’incertitude de la littérature en critères de réussite définis avant le pilote d’assistant de code.
| Situation observée | Décision ou contrôle | Responsable |
|---|---|---|
| Mesures différentes | Ne pas calculer une moyenne commune | Analyste |
| Contexte proche | Examiner la transférabilité | Métier |
| Décision incertaine | Construire un essai local | Produit |
La décision à retenir
Cherchez d’abord si les études mesurent réellement la même chose. Un gain sur une tâche et une perte sur une autre peuvent décrire une frontière d’usage plutôt qu’une contradiction.
- Votre prochaine étape
- Comparer deux études dans une matrice avant de rédiger leur synthèse.
- Comment juger le résultat
- La conclusion précise l’usage concerné et ce qui reste à tester.
Les limites de cette analyse
- Outils de février–juin 2025 ; ne décrit pas les modèles actuels.
- Une entreprise de support ; ni tous les secteurs ni un chatbot autonome.
- Tâche construite pour tester les limites du modèle.
Sources et résultats utilisés dans cet article
Les passages et le périmètre de lecture sont consultables ci-dessous. L’accès à un texte intégral ne signifie pas que chaque résultat a été audité.
Becker, J., Rush, N., Barnes, B., & Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. arXiv (Cornell University).
DOI : 10.48550/arxiv.2507.09089 ↗Période des données : Tâches : février–juin 2025
Lecture ciblée du texte intégral v2 : pages PDF 1–9, protocole et résultats principaux ; annexes non auditées.
Voir la fiche de preuve
- Constat
- Dans les tâches étudiées, autoriser les outils IA augmente le temps de réalisation de 19 % selon l’estimation ajustée.
- Localisateur
- PDF v2, résumé et sections 2–3, pages 1–9
- Court extrait
- « AI tooling slowed developers down. »
- Méthode
- Essai randomisé au niveau des tâches ; temps déclaré, contrôles par enregistrements sur un sous-ensemble.
- Population
- 16 développeurs expérimentés ; 246 tâches sur leurs projets open source matures.
- Limites
- Outils de février–juin 2025 ; ne décrit pas les modèles actuels. Petit nombre de développeurs et forte familiarité avec les dépôts. 19 % est l’estimation ajustée ; la différence brute est distincte.
Voir la fiche de preuve
- Constat
- Dans les tâches étudiées, autoriser les outils IA augmente le temps de réalisation de 19 % selon l’estimation ajustée.
- Localisateur
- METR · début 2025 · 16 développeurs, 246 tâches
- Court extrait
- « AI tooling slowed developers down. »
- Méthode
- Essai randomisé au niveau des tâches ; temps déclaré, contrôles par enregistrements sur un sous-ensemble.
- Population
- 16 développeurs expérimentés et 246 tâches ; outils du début 2025.
- Limites
- Outils de février–juin 2025 ; ne décrit pas les modèles actuels. Petit nombre de développeurs et forte familiarité avec les dépôts. 19 % est l’estimation ajustée ; la différence brute est distincte.
Erik Brynjolfsson, Danielle Li, & Lindsey Raymond. (2025). Generative AI at Work. RECHERCHE · Quarterly Journal of Economics.
DOI : 10.1093/qje/qjae044 ↗Version publiée consultée ; résumé, population de 5 172 agents et résultat moyen.
Voir la fiche de preuve
- Constat
- L’assistance augmente de 15 % les problèmes résolus par heure en moyenne, avec des effets hétérogènes selon l’expérience.
- Localisateur
- Version publiée consultée ; résumé, population de 5 172 agents et résultat moyen.
- Court extrait
- « Generative AI at Work »
- Méthode
- RECHERCHE · Quarterly Journal of Economics
- Population
- 5 172 agents de support dans l’entreprise étudiée ; déploiement d’une assistance générative.
- Limites
- Une entreprise de support ; ni tous les secteurs ni un chatbot autonome.
Dell’Acqua, F., McFowland, E., Mollick, E., Lifshitz, H., Kellogg, K. C., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality. Organization Science.
DOI : 10.1287/orsc.2025.21838 ↗Période des données : Expérience : avril 2023 (publication finale en 2026)
Lecture ciblée de la publication 2026 : pages PDF 1–3, 6–9 et 11–12, notamment tableaux 2 et 7. Expérience menée avec GPT-4 en 2023.
Voir la fiche de preuve
- Constat
- Sur la tâche hors frontière étudiée, les proportions de réponses correctes sont environ 84 %, 71 % et 60 % selon les conditions.
- Localisateur
- Publication 2026, tableau 2 : proportions arrondies .84/.71/.60 ; tableau 7 pour l’estimation.
- Court extrait
- « outside the frontier »
- Méthode
- Expérience de terrain randomisée ; tâches de conseil, GPT-4 de 2023.
- Population
- 373 consultants dans le volet hors frontière ; 758 dans l’expérience entière.
- Limites
- Tâche construite pour tester les limites du modèle. Les chiffres du tableau 2 sont arrondis ; ne pas les convertir en effets universels.
Nicole Forsgren, Margaret-Anne Storey, Chandra Maddila, Thomas Zimmermann, Brian Houck, & Jenna Butler. (2021). The SPACE of Developer Productivity: There’s more to it than you think. ACM Queue.
Publication originale ↗Résumé primaire consulté ; texte intégral non audité.